感知机学习算法

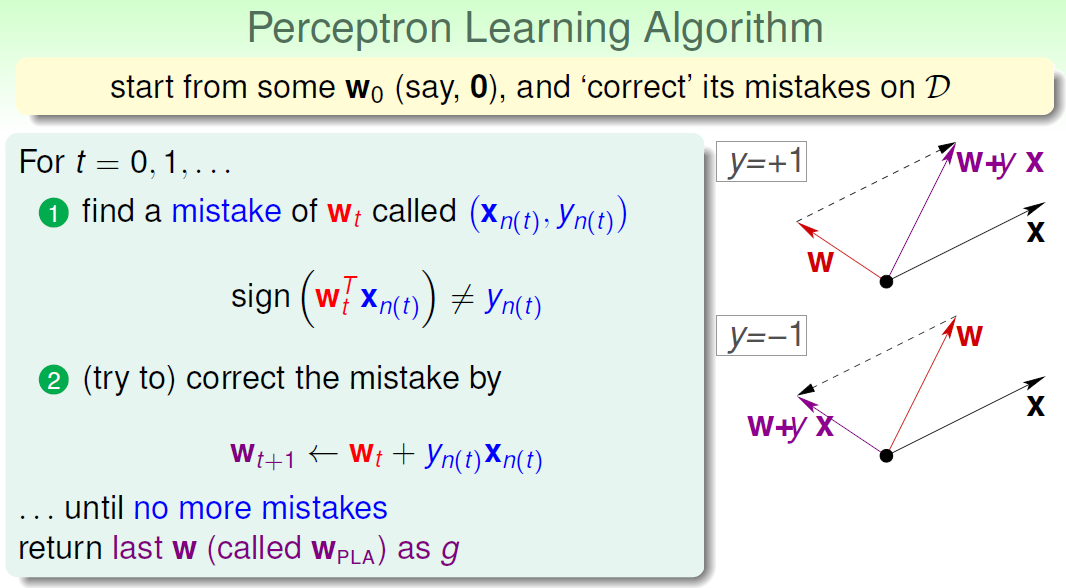
感知机学习问题转化为求解损失函数的最优化问题,最优化的方法就是随机梯度下降法。

1. 学习算法的原始形式

给定一个训练数据集T={(x(1),y(1)),(x(2),y(2)),...,(x(m),y(m))}T=\{(x^{(1)},y^{(1)}),(x^{(2)},y^{(2)}),...,(x^{(m)},y^{(m)})\},其中,x(i)∈X=Rnx^{(i)}\in X= R^n,y(i)∈Y={+1,−1}y^{(i)}\in Y=\lbrace+1,-1\rbrace,i=1,2,...,mi=1,2,...,m,求参数ww,bb,使得其为以下损失函数极小化的解:

minw,bL(w,b)=−∑x(i)∈My(i)(w⋅x(i)+b) \min_{w,b}L(w,b)=-\displaystyle\sum_{x^{(i)}\in M}y^{(i)}(w\cdot x^{(i)}+b)

其中MM为误分类点的集合。

假设误分类点集合MM是固定的,那么损失函数L(w,b)L(w,b)的梯度由

∇wL(w,b)=−∑x(i)∈My(i)x(i) \nabla_w L(w,b)=-\displaystyle\sum_{x^{(i)}\in M}y^{(i)} x^{(i)}

∇bL(w,b)=−∑x(i)∈My(i) \nabla_b L(w,b)=-\displaystyle\sum_{x^{(i)}\in M}y^{(i)}

给出。

1.1 随机梯度下降算法:

输入:训练数据集T={(x(1),y(1)),(x(2),y(2)),...,(x(m),y(m))}T=\{(x^{(1)},y^{(1)}),(x^{(2)},y^{(2)}),...,(x^{(m)},y^{(m)})\},其中,x(i)∈X=Rnx^{(i)}\in X= R^n,y(i)∈Y={+1,−1}y^{(i)}\in Y=\lbrace+1,-1\rbrace,i=1,2,...,mi=1,2,...,m,学习率为η(0<η⩽1) \eta(0<\eta\leqslant1)

输出:w,bw,b:感知机模型f(x)=sign(w⋅x+b)f(x)=sign(w\cdot x+b)

  1. 选取初始值w0,b0w_0,b_0
  2. 在训练集中选取数据(x(i),y(i))(x^{(i)},y^{(i)})
  3. 如果y(i)(w⋅x(i)+b)⩽0y^{(i)}(w\cdot x^{(i)}+b)\leqslant0,则w←w+ηy(i)x(i)w \gets w+\eta y^{(i)} x^{(i)},b←b+ηy(i)b \gets b+\eta y^{(i)}
  4. 转至步骤(2),直至训练集里面的每个点都不是误分类点,这个过程中训练集中的点可能会被重复的选中并计算。

1.2 直观的解释

当出现误分类点时,则调整w,bw,b,更正超平面的方向,使其稍微转向正确的方向。

1.3 算法的收敛性

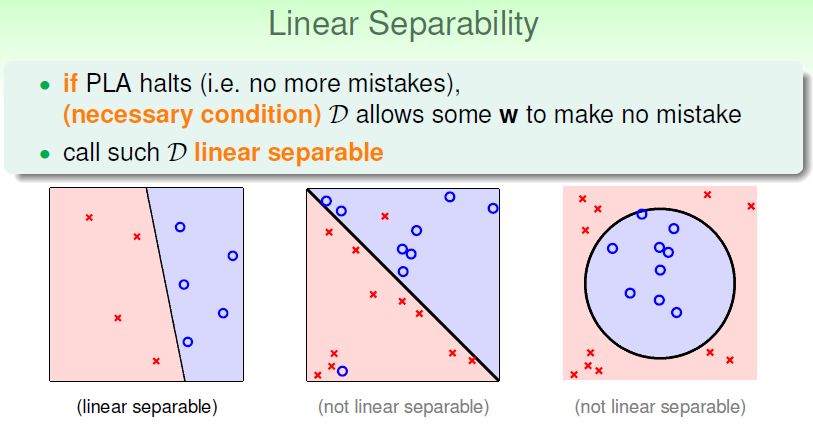
可以证明,对于线性可分的数据集,感知机学习算法经过有限次迭代可以得到一个将训练数据集完全正确划分的分离超平面及感知机模型。
2.学习算法的对偶形式

对偶形式的基本想法是,将ww和bb表示为实例向量x(i)x^{(i)}和标记y(i)y^{(i)}的线性组合的形式,通过求解其系数而求得ww和bb。

从上面的算法中可假设初始值w0,b0w_0,b_0均为0。对某个误分类点(x(i),y(i))(x^{(i)},y^{(i)})经过w←w+ηy(i)x(i)w \gets w+\eta y^{(i)} x^{(i)}和b←b+ηy(i)b \gets b+\eta y^{(i)}迭代修改,假设修改了kk次后,w,bw,b 关于该误分类点的最后的总增量为αiy(i)x(i)\alpha_i y^{(i)}x^{(i)}和αiy(i)\alpha_iy^{(i)},这里αi=kiη\alpha_i=k_i\eta。对于训练集中的每一个点都有αi\alpha_i,所有的训练数据点的分量构成向量α=(α1,α2,...,αm)T\alpha =(\alpha_1,\alpha_2,...,\alpha_m)^T,这样最后得到的w,bw,b可以分别表示为(有的αi\alpha_i可能为0):

w=∑i=1mαiy(i)x(i)=∑i=1mkiηy(i)x(i) w = \displaystyle\sum_{i=1}^m\alpha_iy^{(i)}x^{(i)}=\displaystyle\sum_{i=1}^mk_i\eta y^{(i)}x^{(i)}

b=∑i=1mαiy(i)=∑i=1mkiηy(i) b = \displaystyle\sum_{i=1}^m\alpha_iy^{(i)} = \displaystyle\sum_{i=1}^mk_i\eta y^{(i)}

2.1 算法的对偶形式

输入:线性可分的数据集T={(x(1),y(1)),(x(2),y(2)),...,(x(m),y(m))}T=\{(x^{(1)},y^{(1)}),(x^{(2)},y^{(2)}),...,(x^{(m)},y^{(m)})\},其中x(i)∈X=Rnx^{(i)}\in X= R^n,y(i)∈Y={+1,−1}y^{(i)}\in Y=\lbrace+1,-1\rbrace,i=1,2,...,mi=1,2,...,m,学习率η(0<η⩽1) \eta(0<\eta\leqslant1)

输出:α,b\alpha,b;感知机模型f(x)=sign(∑j=1mαjy(j)x(j)⋅x+b)f(x)=sign(\displaystyle\sum_{j=1}^m\alpha_jy^{(j)}x^{(j)}\cdot x+b),其中α=(α1,α2,...αm)T\alpha=(\alpha_1,\alpha_2,...\alpha_m)^T

  1. 选取初始值α=(0,0,...,0),b=0\alpha =(0,0,...,0), b=0
  2. 在训练集中选取数据(x(i),y(i))(x^{(i)},y^{(i)})
  3. 如果y(i)(∑j=1mαjy(j)x(j)⋅x(i)+b)⩽0y^{(i)}(\displaystyle\sum_{j=1}^m\alpha_jy^{(j)}x^{(j)}\cdot x^{(i)}+b)\leqslant0,则αi←αi+η\alpha_i \gets \alpha_i+\eta ,b←b+ηy(i)b \gets b+\eta y^{(i)},也就是每次只更新向量α\alpha的第ii个分量
  4. 转至步骤(2),直到没有误分类点为止。

观察可以看到步骤3中每次更新的x(j)⋅x(i)x^{(j)}\cdot x^{(i)}可以事先计算好并以矩阵的形式存储,那么就不需要每次都计算,

这样的矩阵称为Gram矩阵(Gram matrix):

G=[x(i)⋅x(j)]m×m G=[x^{(i)}\cdot x^{(j)}]_{m\times m}

G=[x(1)⋅x(1)x(1)⋅x(2)x(1)⋅x(3)...x(1)⋅x(m)x(2)⋅x(1)x(2)⋅x(2)x(2)⋅x(3)...x(2)⋅x(m)x(3)⋅x(1)x(3)⋅x(2)x(3)⋅x(3)...x(3)⋅x(m)...x(m)⋅x(1)x(m)⋅x(2)x(m)⋅x(3)...x(m)⋅x(m)] G= \begin{bmatrix} x^{(1)}\cdot x^{(1)} & x^{(1)}\cdot x^{(2)} & x^{(1)}\cdot x^{(3)} & ... & x^{(1)}\cdot x^{(m)}\\ x^{(2)}\cdot x^{(1)} & x^{(2)}\cdot x^{(2)} & x^{(2)}\cdot x^{(3)} & ... & x^{(2)}\cdot x^{(m)} \\ x^{(3)}\cdot x^{(1)} & x^{(3)}\cdot x^{(2)} & x^{(3)}\cdot x^{(3)} & ... & x^{(3)}\cdot x^{(m)} \\ ... \\ x^{(m)}\cdot x^{(1)} & x^{(m)}\cdot x^{(2)} & x^{(m)}\cdot x^{(3)} & ... & x^{(m)}\cdot x^{(m)} \end{bmatrix}

则关于∑j=1mαjy(j)x(j)⋅x(i)\displaystyle\sum_{j=1}^m\alpha_jy^{(j)}x^{(j)}\cdot x^{(i)}的计算,∑j=1mαjy(j)x(j)⋅x(i)=∑j=1mαjy(j)G[i,j]=∑α∘y∘G[i]\displaystyle\sum_{j=1}^m\alpha_jy^{(j)}x^{(j)}\cdot x^{(i)} = \displaystyle\sum_{j=1}^m\alpha_jy^{(j)}G[i,j]= \sum \alpha \circ y \circ G[i],即三个向量中每个元素相乘再做和运算。

参考:林轩田,机器学习基石

results matching ""

    No results matching ""